【導讀】近日,智譜正式開源GLM-5.3-Flash(320B-A18B),這款在匿名公測中登頂OpenCode與OpenRouter雙平臺調用量榜首的原生多模態模型,以57分的AA綜合智能指數進入全球前沿模型區間。模型發布當日,摩爾線程即基于AI訓推一體智算卡MTT S5000及MUSA軟件棧完成極速適配與高效運行,針對模型中KDA線性注意力機制等創新架構,實現了從算子定制到推理全鏈路的深度打通。
全球前沿性能,匿名公測登頂雙榜
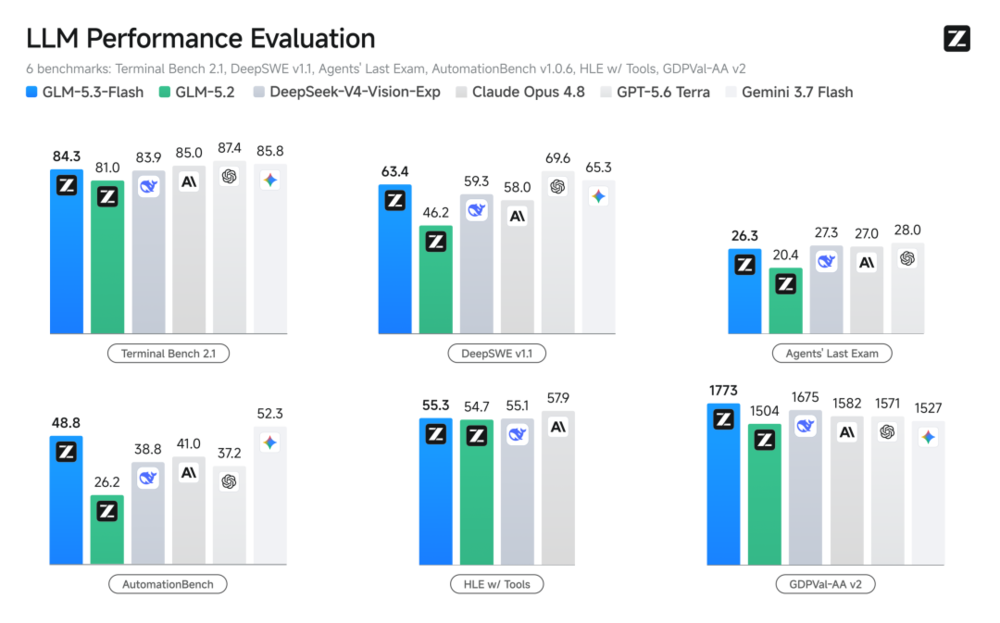
作為GLM-5系列的首個原生多模態模型,GLM-5.3-Flash總參數為320B,激活參數僅18B,在全球權威的Artificial Analysis Intelligence Index(AA綜合智能指數)中取得57分,進入全球前沿模型能力區間,與Anthropic最受歡迎的模型Claude Opus 4.8得分持平。在自研Z.ai Code Bench體感評估中,其編程表現與Claude Opus 4.8相當。
此前,該模型以代號Ox-Alpha(社區昵稱“牛來”)在OpenCode和OpenRouter進行匿名公測,憑借出色的推理速度與智能表現,迅速成為當周最受歡迎的模型,創下雙平臺調用量新高。
全棧技術閉環,極速打通推理全鏈路
GLM-5.3-Flash發布當日,摩爾線程工程團隊迅速完成模型架構拆解、核心技術分析與典型算子梳理。針對其混合架構中線性注意力采用的KDA機制,團隊基于MATE算子優化引擎,快速完成了狀態矩陣更新、分塊并行掃描等全新算子形態的定制實現與深度調優,并與SGLang-MUSA緩存管理體系深度協同、無縫打通,充分釋放了KDA在長上下文推理中的效率優勢。
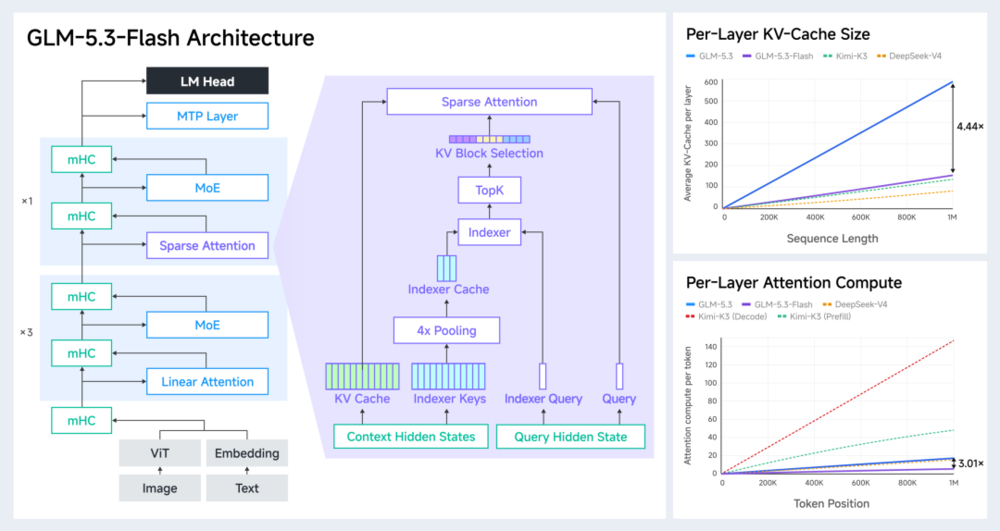
KDA機制的核心創新在于,將傳統注意力中隨推理長度線性增長的KV Cache,轉化為固定規模狀態矩陣的增量更新——顯存占用不再隨序列變長而膨脹,從根本上大幅緩解了長上下文的顯存壓力。這一前沿架構特性與MTT S5000的高算力密度形成深度協同,為GLM-5.3-Flash超長上下文能力在國產算力平臺上的高效、穩定運行提供了堅實支撐。
軟硬協同,夯實國產算力底座
本次極速適配充分驗證了MTT S5000智算卡的高算力密度與穩定性,展現了MUSA架構“適配—部署—優化”工程體系的高效成熟。摩爾線程以自主軟硬件協同能力,為國產AI算力底座建設提供了有力支撐。
GLM-5.3-Flash開源地址:
https://huggingface.co/zai-org/GLM-5.3-Flash
開發者可下載鏡像進行開箱體驗:
registry.mthreads.com/mcconline/inference/sglang:v0.5.17-s5000-4.3.5-torch2.9.1-20260827-glm
結論
從GLM-5.3-Flash發布到摩爾線程完成全鏈路適配,這場“發布即適配”的高效協同,展現了國產AI產業鏈日益成熟的協同能力。MTT S5000的高算力密度與MUSA軟件棧的工程效率,成功承載了KDA機制在長上下文推理中的顯存優化優勢,使320B參數的超級模型能夠在國產算力平臺上穩定、高效運行。這不僅是一次技術驗證,更是一次產業信心的建立——當頂尖大模型與自主算力底座之間的適配周期從“數月”壓縮至“當日”,AGI的產業化規模普惠便不再是遙遠的愿景。